弱连通分量(WCC)
本文介绍弱连通分量(Weakly Connected Components, WCC)算法,并演示如何用 GQL 实现该算法。
算法介绍
弱连通分量用于在有向图中识别点的分组:如果忽略边的方向性,则组内任意两个点之间都存在一条路径。换言之,将所有有向边视作无向边后,弱连通分量即为一个极大点集合,其中任意点都可到达集合内的其他点。
计算 WCC 的一种常见方法是标签传播:
- 将每个点的标签初始化为其自身的 ID。
- 通过无向边迭代传播最小标签。
- 当没有点可以被更小的标签更新时,所有拥有相同标签的点属于同一弱连通分量。即,同一弱连通分量中的所有点标签相同,且等于该分量内点 ID 的最小值。
关于 WCC 的更多信息,请参见分量(图论)。
数据模型
为了用 GQL 实现 WCC,将基于以下数据模型来创建图类型:
- 用类型为
Person的点表示人。 - 用类型为
Knows的边表示人之间的关系。
尽管Knows边以有向形式存储,但在匹配时 WCC 算法会将其视为无向边,以正确识别弱连通性。
该图类型的完整定义,请参见准备图数据。
过程实现
为了计算图的弱连通分量,将创建一个执行标签传播直至收敛的过程。
该过程的完整定义,请参见创建过程。下文将介绍该过程的关键元素及其工作原理。
该过程不接收输入参数,且定义了以下变量:
| 变量 | 类型 | 说明 |
|---|---|---|
component_id |
点绑定 MinAgg 聚合值变量 | 每个点当前的标签(初始化为该点的 ID)。MinAgg 聚合器确保点保留最小标签。 |
comp_count |
全局 MapAgg 聚合值变量 | 用于统计每个分量中的点数量的映射。 |
new_active |
全局 OrAgg 聚合值变量 | 全局布尔标记,表示本轮是否发生更新;决定是否继续迭代。 |
v_set |
活动集变量 | 下一轮要处理的点活动集,将迭代限制在受更新影响的点上。 |
output_file_node和output_file_count |
文件变量 | 前者用于导出每个点的最终分量 ID,后者用于导出每个分量的点数量。 |
result_table |
表变量 | 表变量,用于收集每个点的最终分量 ID,以便汇总和返回。 |
过程逻辑如下:
- 为每个点将其
component_id初始化为自身 ID。用所有点初始化活动集v_set。 - 当
new_active为true时重复:- 将
new_active置为false。 - 对
a在当前活动集中的每条无向边(a—b):若a.component_id<b.component_id,则通过MinAgg将b.component_id更新为更小值,并将new_active置为true。 - 将每个被更新的点
b加入下一轮的活动集v_set。
- 将
- 收敛后(无更新发生),将每个点的 ID 和最终
component_id通过文件变量(output_file_node和output_file_count)或表变量(result_table)导出到文件或表。 - 将相同
component_id的点归为一组,并返回每个component_id对应的点数量。
操作步骤
在悦数图管理的控制台中,按顺序执行以下代码块。首次使用时,先按准备算法示例数据确认操作位置和目录挂载。
1. 准备图数据
-
创建与数据模型匹配的图类型。
''' CREATE GRAPH TYPE IF NOT EXISTS wcc_graph_type AS { NODE Person (LABEL Person {id INT PRIMARY KEY}), EDGE Knows (Person)-[LABEL Knows {MULTIEDGE KEY ()}]->(Person) } ''' -
下载以下 CSV 文件,保留文件名,保存到部署目录下的
examples/algorithms/wcc/:- wcc_node.csv:点数据。
- wcc_edge.csv:边数据。
查看 CSV 内容
wcc_node.csvid 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30wcc_edge.csvsrc,dst 1,2 2,3 2,4 4,5 5,1 6,7 6,8 8,9 9,10 10,7 11,12 13,15 15,11 12,11 14,11 17,16 16,18 18,19 20,19 20,1 20,21 21,22 22,23 23,24 24,25 27,26 26,27 27,28 28,29 -
基于图类型创建临时图,并将数据文件加载到该临时图中。
CREATE TEMPORARY GRAPH IF NOT EXISTS #wcc_graph TYPED wcc_graph_type''' USE #wcc_graph IMPORT INTO GRAPH { NODE (v@Person {id: id}) FROM DATAFILE { PATH: "file:///examples/algorithms/wcc/wcc_node.csv", FORMAT: "CSV", DELIMITER: ',' }, EDGE (id: src)-[e@Knows{}]->(id: dst) FROM DATAFILE { PATH: "file:///examples/algorithms/wcc/wcc_edge.csv", FORMAT: "CSV", DELIMITER: ',' } } '''导入成功后,在控制台执行以下查询核对点数:
''' USE #wcc_graph MATCH (n) RETURN count(n) AS node_count '''node_count应为30。点数不符时,先按文件问题排查检查文件和导入结果。上述临时图
#wcc_graph中,各点关系如下图所示: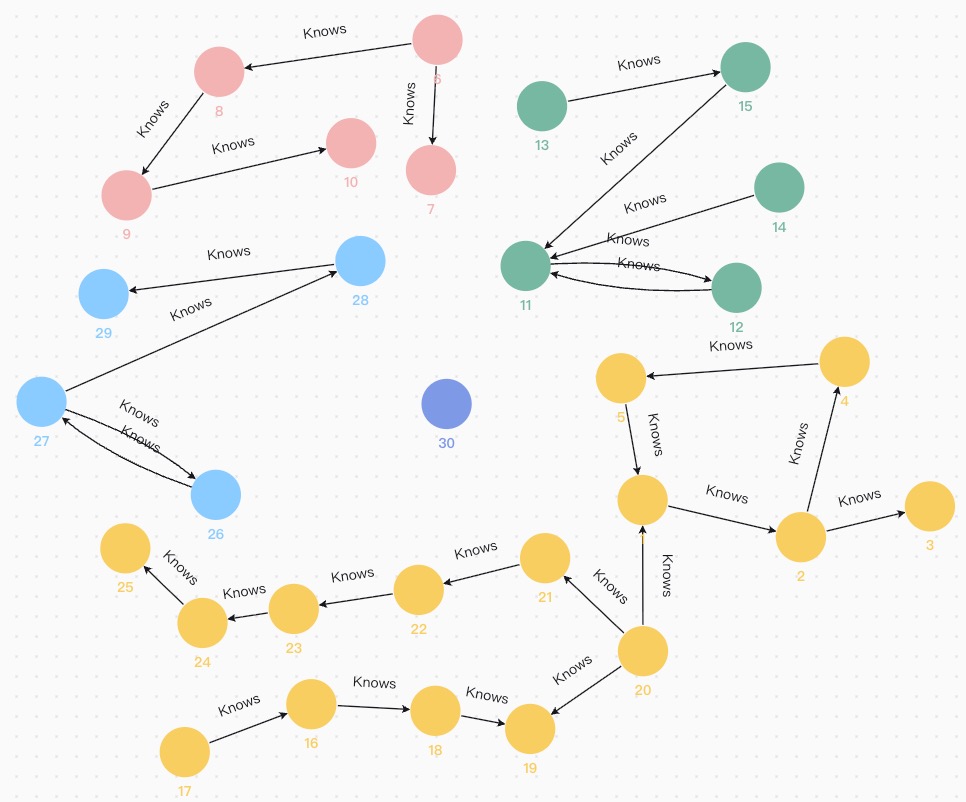
点关系示意图
2. 创建过程
选择一种输出方式,执行对应页签中的过程定义。后续调用时使用相同方式。
'''
CREATE OR REPLACE PROCEDURE wcc() RETURNS () AS {
    NODE VALUE  component_id  MinAgg<INT> = 0
    VALUE       comp_count    MapAgg<INT,SumAgg<INT>>
    VALUE       new_active    OrAgg = true
    FILE        output_file_node   {id INT, component_id INT} = DATAFILE {
                              PATH: "file:///examples/algorithms/wcc/output/nodes",
                              FORMAT: "CSV"
                              }
    FILE        output_file_count  {component_id INT, count INT} = DATAFILE {
                              PATH: "file:///examples/algorithms/wcc/output/counts",
                              FORMAT: "CSV"
                              }
    VALUE       v_set         ACTIVE_SET

    MATCH (a@Person)
    PER NODE (a) {
      SET a.@component_id = a.id
    }
    FINALLY {
      SET v_set = a
    }

    WHILE @new_active = true THEN {
      SET @new_active = false
      MATCH (a@Person)-[e@Knows]-(b)
      WHERE a.@component_id < b.@component_id
            AND a IN v_set
      PER PATH {
        SET b.@component_id += a.@component_id
        SET @new_active += true
      }
      FINALLY {
        SET v_set = b
      }
    }

    MATCH (a@Person)
    PER NODE (a) {
      SET @comp_count += TUPLE(a.@component_id, 1)
      EXPORT a.id, a.@component_id INTO output_file_node
    }

    FOR r IN @comp_count
    EXPORT r._0, r._1 INTO output_file_count

}
'''
'''
CREATE OR REPLACE PROCEDURE wcc() RETURNS (component_id INT64, count INT64) AS {
    NODE VALUE  component_id  MinAgg<INT> = 0
    VALUE       new_active    OrAgg = true
    TABLE       result_table  TYPED TABLE {id INT, component_id INT}
    VALUE       v_set         ACTIVE_SET
    MATCH (a@Person)
    PER NODE (a) {
      SET a.@component_id = a.id
    }
    FINALLY {
      SET v_set = a
    }
    WHILE @new_active = true THEN {
      SET @new_active = false
      MATCH (a@Person)-[e@Knows]-(b)
      WHERE a.@component_id < b.@component_id
            AND a IN v_set
      PER PATH {
        SET b.@component_id += a.@component_id
        SET @new_active += true
      }
      FINALLY {
        SET v_set = b
      }
    }
    MATCH (a@Person)
    PER NODE (a) {
      EXPORT a.id, a.@component_id INTO result_table
    }
    FOR r IN result_table
    RETURN r.component_id AS component_id, count(*) AS count GROUP BY (component_id)
}
'''
3. 调用过程
计算各点所属的弱连通分量。选择与创建过程时相同的输出方式。
USE #wcc_graph CALL wcc() FINISH
此调用将结果写入 CSV,控制台不返回结果表。
在宿主机的部署目录下查看两类结果:
examples/algorithms/wcc/output/nodes/:每个点所属的分量。examples/algorithms/wcc/output/counts/:各分量的点数量。
分量点数文件的示例内容如下:
"r._0","r._1"
30,1
26,4
11,5
6,5
1,15
r._0和r._1分别表示分量内最小的点 ID 和该分量的点数量。
USE #wcc_graph CALL wcc() RETURN *
返回:
+--------------+-------+
| component_id | count |
+--------------+-------+
| 1            | 15    |
| 6            | 5     |
| 11           | 5     |
| 26           | 4     |
| 30           | 1     |
+--------------+-------+
component_id和count分别表示分量内最小的点 ID 和该分量的点数量。
该结果与上述点关系示意图相对应。
将结果写入图中
若要将 WCC 结果持久化到图,请参见 EXPORT。